Способов закрыть страницу несколько, и они решают разные задачи. Разбираем, чем они отличаются, почему самый популярный не делает того, чего от него ждут, и как выбрать нужный.
Коротко
- robots.txt запрещает обход, noindex — попадание в индекс.
- Закрытая в robots.txt страница может остаться в выдаче.
- Чтобы noindex сработал, страница должна быть доступна роботу.
- Сочетание двух запретов сразу — частая ошибка.
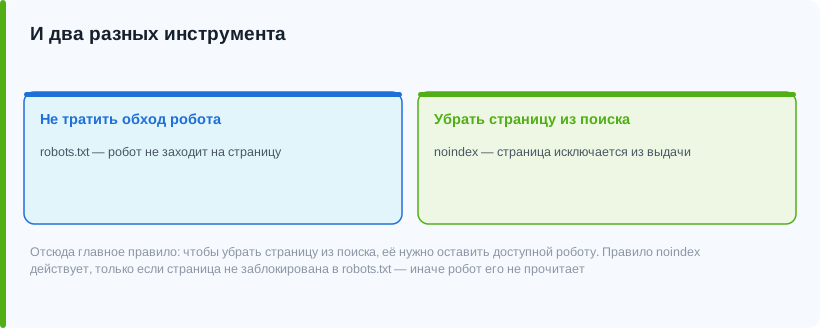
Две разные задачи
| Задача | Чем решается | Что происходит |
|---|---|---|
| Не тратить обход робота | robots.txt | Робот не заходит на страницу |
| Убрать страницу из поиска | noindex | Страница исключается из выдачи |
Из этого следует главное практическое правило: чтобы убрать страницу из поиска, её нужно оставить доступной роботу. По документации, правило noindex действует, только если страница не заблокирована в robots.txt и доступна для обхода. Заблокированная страница может остаться в результатах поиска — например, если на неё ссылаются другие страницы.
Все способы
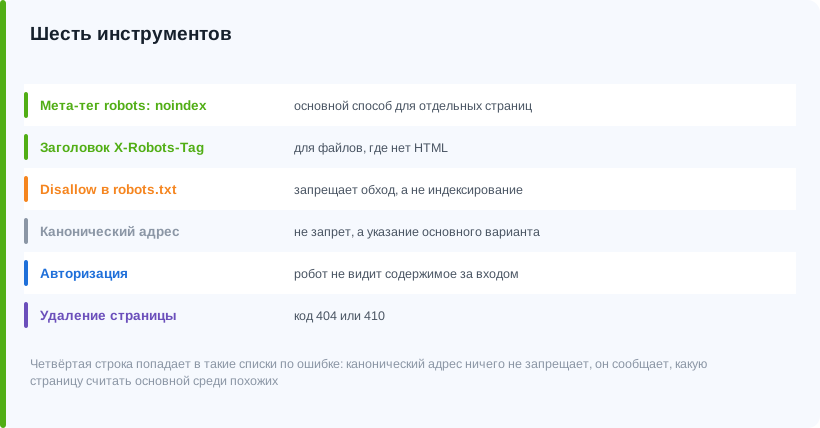
Мета-тег robots со значением noindex
Основной способ для отдельных страниц.
Заголовок X-Robots-Tag
Для файлов, где нет HTML: документов, изображений.
Директива Disallow в robots.txt
Запрещает обход, а не индексирование.
Канонический адрес на другую страницу
Не запрет, а указание основного варианта.
Авторизация
Робот не видит содержимое за входом.
Удаление страницы
С кодом 404 или 410.
Четвёртая строка попадает в такие списки по ошибке, и это стоит проговорить. Канонический адрес не запрещает ничего: он сообщает, какую страницу считать основной среди похожих. Поиск может учесть его или не учесть. Разбор — в статьях про мета-тег robots и canonical.
Какой способ под какую задачу
| Ситуация | Что использовать |
|---|---|
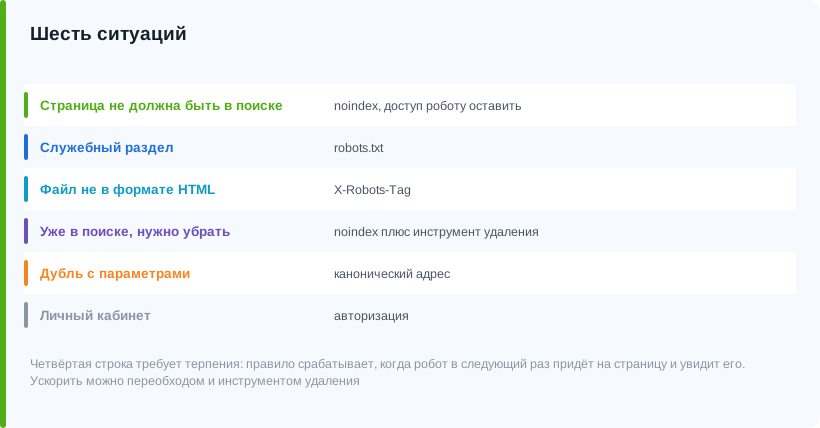
| Страница не должна быть в поиске | noindex, доступ роботу оставить |
| Служебный раздел, который незачем обходить | robots.txt |
| Файл не в формате HTML | X-Robots-Tag |
| Страница уже в поиске, нужно убрать | noindex плюс инструмент удаления |
| Дубль с параметрами | Канонический адрес |
| Личный кабинет | Авторизация |
Четвёртая строка требует терпения. Правило noindex срабатывает, когда робот в следующий раз придёт на страницу и увидит его; ускорить это можно переобходом и инструментом удаления. Про срочное удаление — в статье про удаление страницы из поиска.
Частые ошибки
Что делают не так
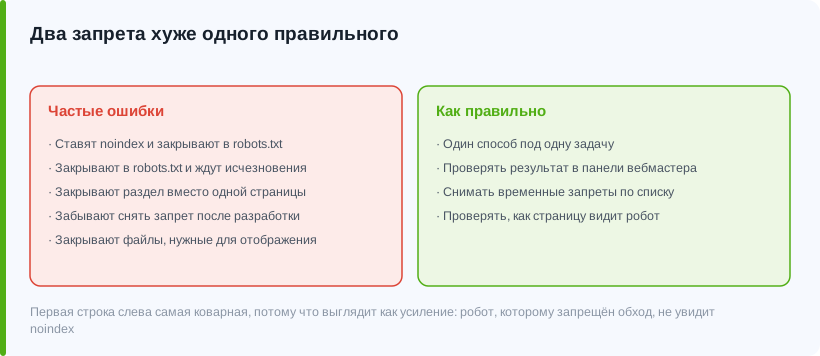
- Ставят noindex и закрывают в robots.txt
- Закрывают в robots.txt и ждут исчезновения из поиска
- Закрывают раздел целиком вместо одной страницы
- Забывают снять запрет после разработки
- Закрывают служебные файлы, нужные для отображения
Как правильно
- Один способ под одну задачу
- Проверять результат в панели вебмастера
- Снимать временные запреты по списку
- Проверять, как страницу видит робот
Первая строка слева — самая коварная, потому что выглядит как усиление. Робот, которому запрещён обход, не увидит noindex — и страница может остаться в выдаче. Два запрета вместе работают хуже, чем один правильный.
Как проверить, что сработало
Посмотрите страницу в панели вебмастера
Там виден статус и причина исключения.
Проверьте исходный код
Тег должен быть в HTML, а не в скрипте.
Проверьте заголовки ответа
Для X-Robots-Tag это единственный способ.
Убедитесь, что страница не закрыта в robots.txt
Иначе запрет не будет прочитан.
Дайте роботу время
Изменения вступают в силу после переобхода.
Второй пункт стоит проверять на реально отдаваемом коде, а не в редакторе шаблона. Тег, добавленный скриптом после загрузки, может быть не учтён, а тег в шаблоне — не попасть на нужный тип страниц. Смотреть нужно на то, что видит робот. Про проверку — в статье про проверку страницы в индексе.
Частые вопросы
Чем robots.txt отличается от noindex?
robots.txt запрещает обход страницы, noindex запрещает включать её в индекс. Это разные задачи, и подменять одно другим нельзя.
Почему закрытая в robots.txt страница осталась в поиске?
Потому что робот не заходит на неё и не видит правило noindex. Заблокированная страница может остаться в результатах, например если на неё ссылаются другие страницы.
Можно ли поставить noindex и закрыть страницу в robots.txt?
Нет. Правило noindex действует, только если страница не заблокирована в robots.txt и доступна роботу. Два запрета вместе работают хуже, чем один правильный.
Как закрыть от индексации файл, который не HTML?
Заголовком X-Robots-Tag: мета-тег в таких файлах поставить некуда, а заголовок отдаёт сервер вместе с файлом.
Читайте также
Продвинем сайт в поиске
Соберём семантику, доведём структуру и текст до уровня топа и будем вести проект до заявок.
Обсудить SEO-продвижение