robots.txt — первый файл, который робот запрашивает у сайта, и самый простой способ случайно закрыть себе трафик. Одна лишняя строка — и из поиска пропадает раздел каталога. При этом от него ждут того, чего он не умеет: убрать страницу из выдачи. Разбираемся, что он делает на самом деле, какие директивы работают и где чаще всего ошибаются.
Коротко
- robots.txt запрещает обход страницы, но не гарантирует, что её не будет в поиске.
- Чтобы убрать страницу из индекса, нужен noindex — а для этого робот должен страницу прочитать.
- При конфликте Allow и Disallow побеждает более длинное правило, а не то, что выше.
- Файл лежит только в корне домена и действует только на свой домен и протокол.
Что robots.txt умеет и чего не умеет
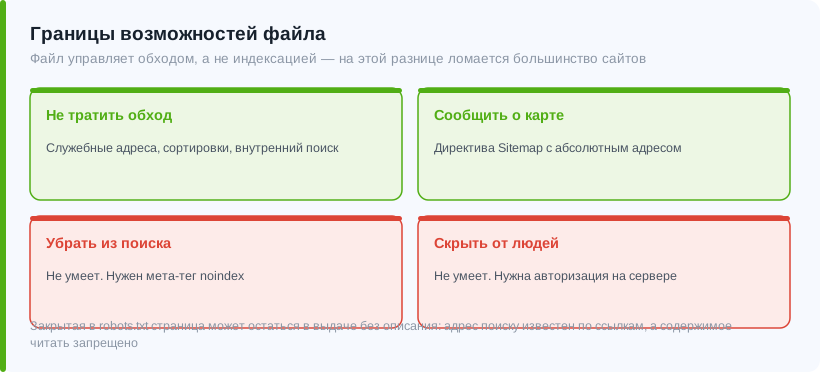
Файл управляет обходом: говорит роботу, какие адреса не запрашивать. Это не запрет на индексацию и не средство защиты.
| Задача | robots.txt | Чем решать |
|---|---|---|
| Не тратить обход на служебные адреса | Подходит | Disallow |
| Убрать страницу из поиска | Не подходит | Мета-тег noindex |
| Скрыть страницу от людей | Не подходит | Авторизация на сервере |
| Убрать дубли из индекса | Не подходит | canonical или 301 |
| Сообщить о карте сайта | Подходит | Sitemap |
Главное недоразумение. Закрытая в robots.txt страница может остаться в выдаче — без описания, с пометкой вроде «нет информации об этой странице». Так происходит, когда на неё ведут внешние ссылки: адрес поиску известен, а содержимое запрещено читать. Чтобы страница ушла из индекса, нужен noindex, а для этого её, наоборот, нужно открыть для обхода.
Директивы, которые действительно работают
| Директива | Что делает | Яндекс | |
|---|---|---|---|
| User-agent | К какому роботу относятся правила ниже | да | да |
| Disallow | Запрещает обход адресов по маске | да | да |
| Allow | Разрешает исключение внутри запрета | да | да |
| Sitemap | Указывает адрес карты сайта | да | да |
| Clean-param | Убирает незначащие параметры из адреса | да | нет |
| Crawl-delay | Пауза между запросами робота | не учитывается | нет |
| Host | Главное зеркало | не учитывается | нет |
Crawl-delay и Host остались в файлах многих сайтов с прошлых лет. Вреда от них нет, пользы тоже: скорость обхода настраивается в Вебмастере, а главное зеркало определяется редиректами и canonical.
Спецсимволы
*— любая последовательность символов.Disallow: /*?закроет все адреса с параметрами.$— конец адреса.Disallow: /catalog$закроет только/catalog, но не/catalog/divany.#— комментарий до конца строки.
Как разрешаются конфликты правил
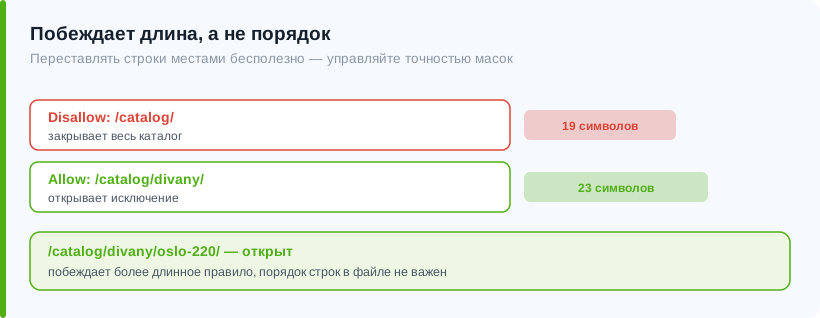
Самое неочевидное место. Если под адрес подходят и Disallow, и Allow, побеждает более длинное правило — то, где больше символов до подстановки. Порядок строк в файле значения не имеет.
Возьмём такой фрагмент:
Disallow: /catalog/Allow: /catalog/divany/
Адрес /catalog/divany/oslo-220/ будет открыт: правило Allow длиннее и конкретнее. Остальной каталог останется закрытым.
Практический вывод. Не пытайтесь управлять приоритетом, переставляя строки местами — это ничего не меняет. Управляйте длиной и точностью масок. И проверяйте результат инструментом, а не на глаз: ошибиться в маске со звёздочкой очень легко.
Что стоит закрывать, а что нет
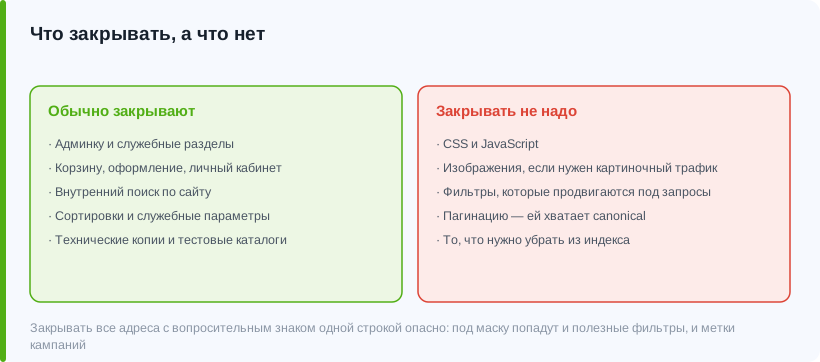
Обычно закрывают
- Админку и служебные разделы
- Корзину, оформление заказа, личный кабинет
- Внутренний поиск по сайту
- Сортировки и служебные параметры
- Технические копии и тестовые каталоги
Закрывать не надо
- CSS и JavaScript — робот должен видеть страницу как человек
- Изображения, если нужен картиночный трафик
- Страницы фильтров, которые продвигаются под запросы
- Пагинацию — вместо неё canonical и разметка
- Страницы, которые нужно убрать из индекса, — им нужен noindex
Отдельно про параметры. Закрывать все адреса с ? одной строкой удобно, но опасно: под маску попадут и полезные фильтры, и UTM-метки на посадочных. Аккуратнее перечислить конкретные параметры или воспользоваться Clean-param для Яндекса.
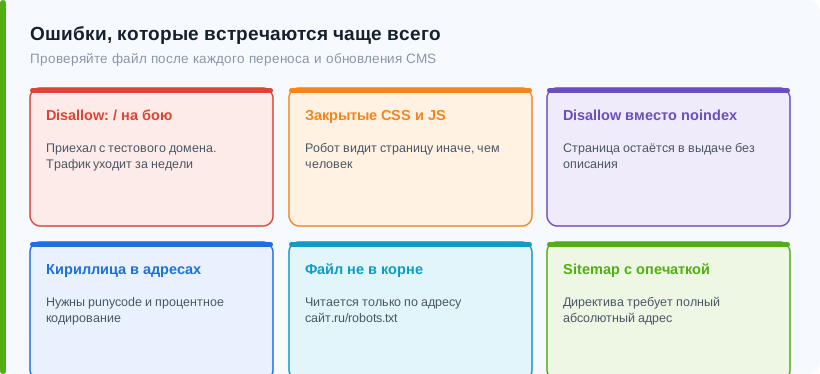
Ошибки, которые встречаются чаще всего
Disallow: / на боевом сайте
Классика: сайт разрабатывали на тестовом домене с полным запретом, выкатили в продакшен вместе с файлом. Трафик уходит за недели, возвращается месяцами.
Закрытые CSS и JS
Робот не может отрисовать страницу и видит её иначе, чем человек. Особенно больно для сайтов, где контент подгружается скриптами.
Попытка убрать страницу из индекса через Disallow
Не работает. Страница остаётся в выдаче без описания, а noindex на ней робот прочитать уже не может.
Кириллица в адресах
В файле нужны адреса в кодировке punycode и percent-encoding. Кириллица как есть не сработает.
Файл не в корне
robots.txt читается только по адресу сайт.ru/robots.txt. В подпапке он не действует, а у поддомена должен быть свой.
Sitemap с неверным адресом
Опечатка, http вместо https или относительный путь. Директива требует полный абсолютный адрес.
Как проверить
- Откройте файл в браузере. Самая первая проверка: он должен отдаваться по адресу
/robots.txtс кодом 200 и как обычный текст. - Анализатор в Яндекс Вебмастере. Показывает, как Яндекс понял ваши правила, и позволяет проверить конкретный адрес.
- Проверка URL в Search Console. Скажет, заблокирован ли адрес для Google и каким именно правилом.
- Краулер по сайту. Покажет, сколько страниц закрыто от обхода — и не попали ли туда нужные.
- Логи сервера. Показывают, что робот на самом деле запрашивает. Самый честный источник, если расхождения непонятны.
Проверяйте после каждого переноса. Перенос сайта, смена хостинга, обновление CMS, выкладка с тестового сервера — в каждом из этих случаев robots.txt может приехать чужой. Пятисекундная проверка экономит месяцы восстановления.
Частые вопросы
Закроет ли robots.txt страницу от поиска?
Нет. Он запрещает обход, а не индексацию. Если на страницу ведут ссылки, она может остаться в выдаче без описания. Чтобы убрать её из поиска, нужен мета-тег noindex, и страница при этом должна быть открыта для обхода.
Нужен ли robots.txt, если закрывать нечего?
Формально нет: при отсутствии файла обход не ограничен. Но файл стоит завести хотя бы ради директивы Sitemap и на случай, когда закрывать что-то понадобится. Пустой файл с одной картой сайта — нормальное решение.
Почему Disallow не сработал?
Чаще всего либо правило перекрыто более длинным Allow, либо маска составлена не так, как вы думали, либо файл закэширован и робот ещё читает старую версию. Проверьте адрес в анализаторе Вебмастера — он покажет, какое правило сработало.
Нужен ли отдельный robots.txt для поддомена?
Да. Каждый поддомен — отдельный хост со своим файлом. robots.txt основного домена на поддомены не распространяется.
Читайте также
Продвинем сайт в поиске
Соберём семантику, доведём структуру и текст до уровня топа и будем вести проект до заявок.
Обсудить SEO-продвижение