Когда нужно убрать страницу из поиска, первым делом тянутся к robots.txt — и это ошибка. Он запрещает обход, а не индексацию. Убрать страницу из выдачи умеет только мета-тег robots со значением noindex либо его аналог в HTTP-заголовке. Разбираемся, чем они отличаются, какие значения бывают и почему эти два инструмента нельзя применять одновременно.
Коротко
- Мета-тег robots управляет индексацией страницы, robots.txt — только её обходом.
- X-Robots-Tag делает то же самое, но через HTTP-заголовок — годится для PDF и картинок.
- noindex вместе с Disallow не работает: робот не прочитает тег на странице, которую ему запретили открывать.
- После снятия noindex страница возвращается в индекс не сразу, а после переобхода.
Мета-тег robots: что это
Ставится в секцию head страницы:
<meta name="robots" content="noindex, follow">
Значение name можно сузить до конкретного робота: yandex или googlebot. Если нужны разные правила для разных систем — пишут несколько тегов.
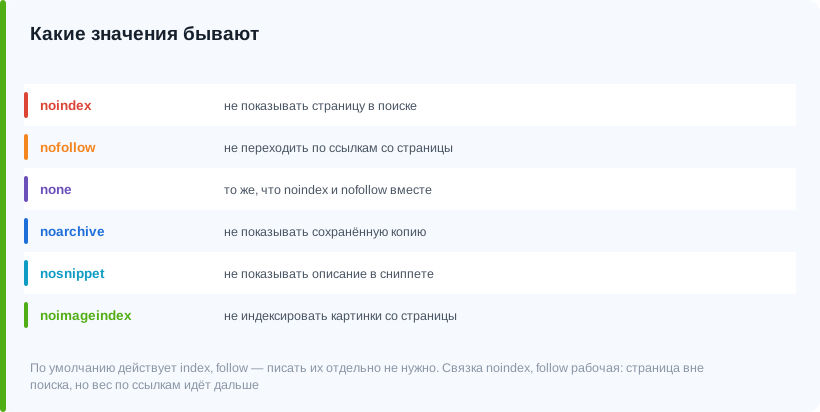
| Значение | Что означает |
|---|---|
| index / noindex | Показывать страницу в поиске или нет |
| follow / nofollow | Переходить по ссылкам со страницы или нет |
| none | То же, что noindex и nofollow вместе |
| noarchive | Не показывать сохранённую копию |
| nosnippet | Не показывать описание в сниппете |
| max-snippet | Ограничить длину описания |
| noimageindex | Не индексировать картинки со страницы |
По умолчанию действует index, follow, поэтому писать их отдельно не нужно — тег без запретов ничего не меняет.
Про сочетание noindex и follow. Это рабочая комбинация: страница не попадёт в поиск, но вес по ссылкам с неё пойдёт дальше. Подходит для страниц фильтров и пагинации, через которые робот добирается до карточек.
X-Robots-Tag: то же самое, но в заголовке
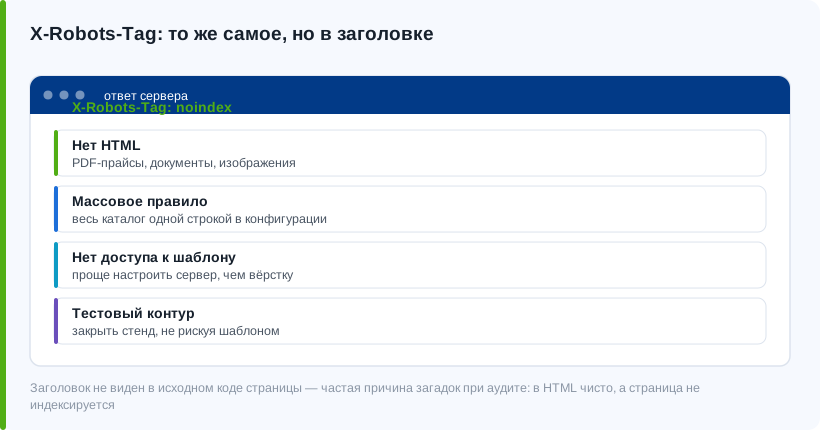
Мета-тег можно поставить только в HTML. А что делать с PDF, изображением или архивом, которые тоже попадают в индекс? Для них есть HTTP-заголовок:
X-Robots-Tag: noindex
Он понимает те же значения и настраивается на стороне сервера — в конфигурации nginx или Apache, либо программно.
Когда удобнее заголовок
- Нет HTML. PDF-прайсы, документы, изображения.
- Массовое правило. Закрыть все файлы одного типа или весь каталог одной строкой в конфигурации, не трогая шаблоны.
- Нет доступа к шаблону. Иногда проще настроить сервер, чем править вёрстку.
- Тестовый контур. Закрыть весь стенд целиком, не рискуя выкатить этот запрет на боевой сайт вместе с шаблоном.
Заголовок не виден в исходном коде страницы. Это частая причина загадок при аудите: в HTML всё чисто, а страница не индексируется. Проверять нужно именно заголовки ответа сервера — в инструментах разработчика или через проверку URL в панелях вебмастера.
Главный конфликт: noindex и Disallow
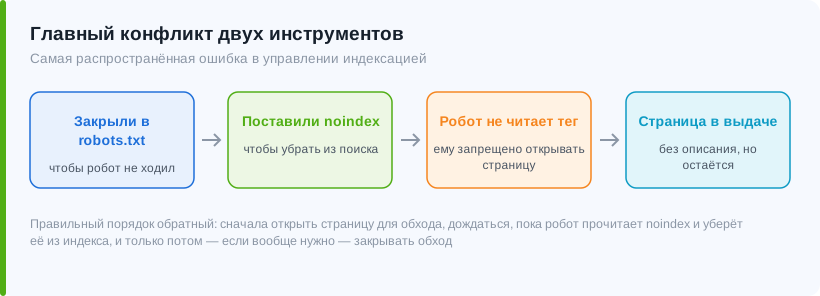
Самая распространённая ошибка в управлении индексацией выглядит логично, но не работает.
Страницу закрывают в robots.txt
Чтобы робот на неё не ходил.
И ставят на неё noindex
Чтобы наверняка убрать из поиска.
Робот не может прочитать тег
Он не запрашивает страницу — ему это запрещено. Значит, про noindex он не узнаёт.
Страница остаётся в выдаче
Без описания, но остаётся: адрес поиску известен по ссылкам.
Правильная последовательность обратная: сначала открыть страницу для обхода, дождаться, пока робот прочитает noindex и уберёт её из индекса, и только потом — если это вообще нужно — закрывать обход.
Когда удобнее оставить открытым. Если страниц немного, закрывать их в robots.txt после снятия из индекса обычно не требуется. Лишний Disallow добавляет риск: однажды кто-нибудь удивится, почему страница не индексируется, и полдня будет искать причину.
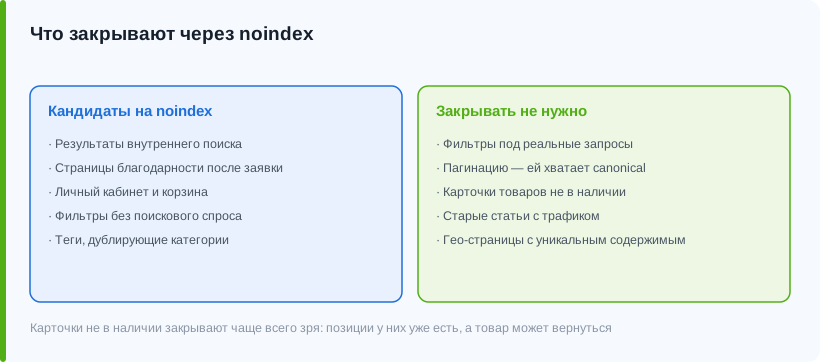
Что обычно закрывают через noindex
Кандидаты на noindex
- Результаты внутреннего поиска
- Страницы благодарности после заявки
- Личный кабинет и корзина
- Фильтры без поискового спроса
- Технические и служебные страницы
- Теги, дублирующие категории
Закрывать не нужно
- Страницы фильтров под реальные запросы
- Пагинацию — ей хватает canonical
- Карточки товаров не в наличии
- Старые статьи с трафиком
- Гео-страницы с уникальным содержимым
Насчёт карточек товаров не в наличии уточнение: их часто закрывают или удаляют, и это почти всегда ошибка. Позиции у такой карточки уже есть, а товар может вернуться. Разумнее оставить страницу, честно показать статус и предложить замену.
Как проверить и сколько ждать
- Исходный код. Ищите
name="robots"в head. Помните, что тег может ставиться скриптом уже после загрузки — тогда в исходнике его не видно. - Заголовки ответа. Вкладка «Сеть» в инструментах разработчика: смотрите X-Robots-Tag в ответе сервера.
- Проверка URL в панелях. И Вебмастер, и Search Console показывают, что именно они увидели на странице и почему её нет в индексе.
- Краулер. Выгрузит директивы со всех страниц разом — так находят случайные noindex, оставшиеся с разработки.
По срокам: страница уходит из индекса после того, как робот её переобойдёт. Для популярных страниц это дни, для редко посещаемых — недели. Ускорить можно переобходом в Вебмастере. Обратный процесс, возвращение после снятия noindex, обычно занимает столько же.
Проверяйте после каждой выкладки. Случайный noindex, приехавший с тестового контура, — одна из самых частых причин внезапной потери трафика. В отличие от robots.txt его не видно снаружи, и замечают проблему обычно через пару недель по просевшим показам.
Частые вопросы
Что надёжнее убирает страницу из поиска: robots.txt или noindex?
Только noindex. robots.txt запрещает обход, но страница может остаться в выдаче без описания, если на неё ведут ссылки. Для удаления из индекса нужен мета-тег или заголовок, и страница при этом должна быть открыта для обхода.
Можно ли ставить noindex и canonical одновременно?
Не стоит: это противоречивые указания. Canonical говорит «учитывай вместо этой другую страницу», noindex — «эту страницу вообще не индексируй». Поиск вынужден выбирать, и результат непредсказуем. Определитесь, что вам нужно.
Как закрыть от индексации PDF-файл?
Заголовком X-Robots-Tag на стороне сервера: мета-тег в PDF не поставить. Правило удобно задать сразу для всех файлов нужного типа в конфигурации веб-сервера.
Через сколько страница пропадёт из поиска после noindex?
После ближайшего переобхода: от нескольких дней до нескольких недель в зависимости от того, как часто робот заходит на страницу. Ускорить можно, отправив её на переобход в Яндекс Вебмастере.
Читайте также
Продвинем сайт в поиске
Соберём семантику, доведём структуру и текст до уровня топа и будем вести проект до заявок.
Обсудить SEO-продвижение