Поисковый робот не обходит сайт бесконечно: у каждого сайта есть предел числа страниц, которые робот готов запросить за отрезок времени. Пока страниц немного, предел незаметен. Но когда их десятки тысяч, оказывается, что робот тратит обход на сортировки и метки, а до новых карточек товаров добирается неделями. Разбираемся, как это увидеть и на что повлиять.
Коротко
- Краулинговый бюджет — сколько страниц робот готов обойти за период. Ограничение реальное, но важно не всем.
- Сайтам до нескольких тысяч страниц об этом обычно думать не нужно.
- Главные растратчики — дубли с параметрами, бесконечные фильтры, цепочки редиректов и мусорные страницы.
- Проверяется по логам сервера и отчётам обхода в Вебмастере, а не на ощупь.
Что это и кому важно
Краулинговый бюджет складывается из двух вещей: сколько запросов сайт выдержит без замедления и насколько поиск заинтересован в его страницах. Первое зависит от сервера, второе — от качества сайта и частоты обновлений.
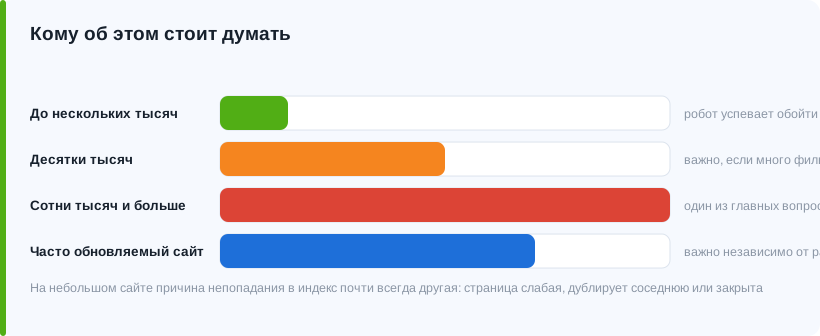
| Размер сайта | Нужно ли думать о бюджете |
|---|---|
| До нескольких тысяч страниц | Обычно нет: робот успевает обойти всё |
| Десятки тысяч | Да, если много фильтров и параметров |
| Сотни тысяч и больше | Да, это один из главных вопросов |
| Часто обновляемый сайт | Да, независимо от размера |
Частая подмена. Краулинговый бюджет любят называть причиной, когда страница не индексируется. На небольшом сайте причина почти всегда другая: страница слабая, дублирует соседнюю или закрыта. Прежде чем оптимизировать обход, убедитесь, что проблема действительно в нём.
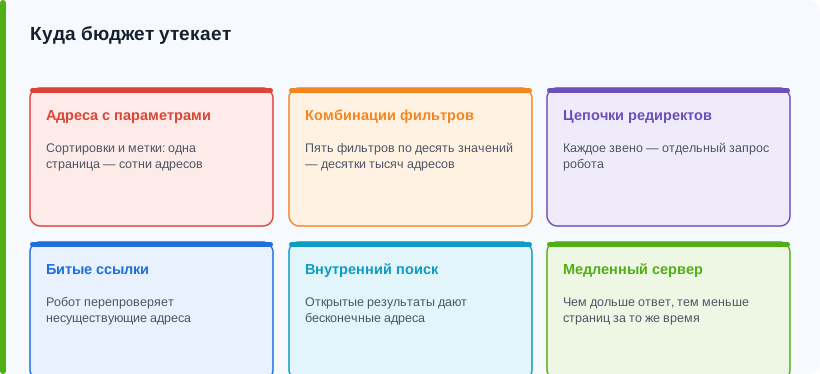
Куда бюджет утекает
Адреса с параметрами
Сортировки, показ по N штук, метки кампаний. Одна страница превращается в сотни адресов с одинаковым содержимым.
Бесконечные комбинации фильтров
Пять фильтров по десять значений дают десятки тысяч адресов, из которых спрос есть у единиц.
Цепочки редиректов
Каждый переход — отдельный запрос. Цепочка из трёх звеньев тратит бюджет втрое.
Битые ссылки
Робот регулярно перепроверяет несуществующие адреса, если на них продолжают вести ссылки с сайта.
Страницы внутреннего поиска
Открытые для обхода результаты поиска порождают бесконечное число адресов.
Медленный сервер
Чем дольше ответ, тем меньше страниц робот успевает запросить за то же время.
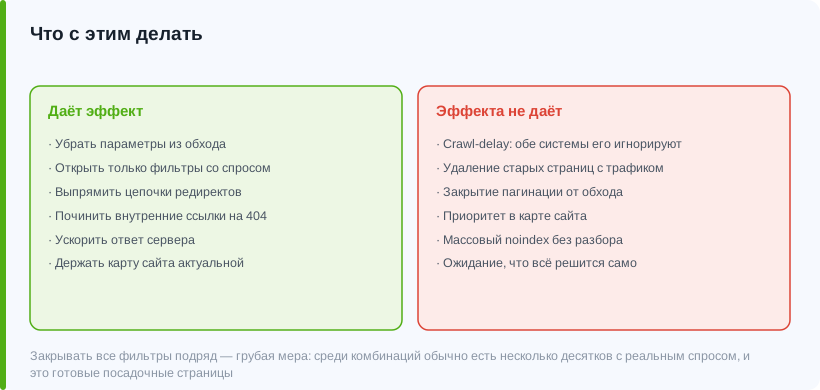
Что с этим делать
Даёт эффект
- Убрать параметры из обхода: Clean-param или Disallow
- Открыть только те фильтры, под которые есть спрос
- Выпрямить цепочки редиректов до одного шага
- Починить внутренние ссылки на 404
- Ускорить ответ сервера
- Поддерживать карту сайта в актуальном виде
Эффекта не даёт
- Crawl-delay: обе системы его игнорируют
- Удаление старых страниц с трафиком
- Закрытие пагинации от обхода
- Приоритет в карте сайта
- Массовый noindex без разбора
Отдельно про фильтры: закрывать их все подряд — распространённая, но грубая мера. Среди комбинаций фильтров обычно есть несколько десятков с реальным спросом, и это готовые посадочные страницы. Разумнее открыть именно их, а остальное закрыть.
Как измерить
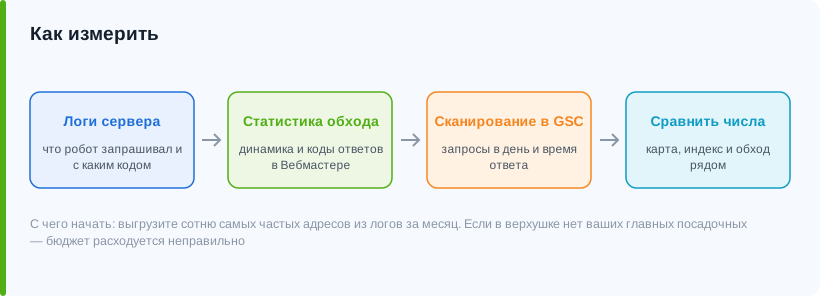
- Логи сервера. Самый честный источник: видно, какие адреса робот запрашивал, сколько раз и с каким кодом ответа. Сразу заметно, если половина запросов уходит на сортировки.
- Статистика обхода в Яндекс Вебмастере. Показывает динамику загруженных страниц и коды ответов.
- Отчёт о статистике сканирования в Search Console. Показывает число запросов в день, среднее время ответа и распределение по типам файлов.
- Сравнение чисел. Сопоставьте количество страниц в карте сайта, в индексе и в обходе. Большой разрыв между обойденными и проиндексированными означает, что робот тратит время не на то.
С чего начать на практике. Выгрузите из логов сотню самых частых адресов, которые запрашивал робот за месяц. Если в верхушке списка нет ваших главных посадочных страниц — бюджет расходуется неправильно, и это уже готовый план работ.
Частые вопросы
Влияет ли краулинговый бюджет на позиции?
Напрямую нет. Но если робот неделями не доходит до новой страницы, она не окажется в поиске — и позиций у неё не будет просто потому, что её нет в индексе. Связь косвенная, но на крупных сайтах ощутимая.
Нужно ли думать о бюджете сайту на 200 страниц?
Практически нет. Робот обойдёт такой сайт целиком без всяких усилий с вашей стороны. Если страницы не индексируются, причина почти наверняка в их качестве или в дублях.
Поможет ли Crawl-delay снизить нагрузку от робота?
Нет, обе поисковые системы эту директиву не учитывают. Скорость обхода настраивается в Яндекс Вебмастере, а в Google — автоматически, с учётом того, как быстро отвечает сервер.
Стоит ли закрывать от обхода страницы пагинации?
Обычно нет: через пагинацию робот добирается до карточек товаров. Закрыв её, вы рискуете тем, что часть каталога вообще перестанет обходиться. Лучше оставить открытой, а от дублей защититься через canonical.
Читайте также
Продвинем сайт в поиске
Соберём семантику, доведём структуру и текст до уровня топа и будем вести проект до заявок.
Обсудить SEO-продвижение