После парсинга Вордстата, подсказок и конкурентов на руках оказывается файл на десятки тысяч строк. Работать с ним в таком виде нельзя: до 90% содержимого — запросы, по которым вы ничего не продаёте и продавать не собираетесь. Чистка — самый скучный и самый недооценённый этап сбора семантики: именно на нём решается, будет ли структура сайта отражать спрос или чужие случайные формулировки.
Коротко
- Чистить нужно от массового к штучному: сначала правила, отсекающие тысячи строк, в конце — ручной просмотр.
- Мусор бывает четырёх видов: технический, нецелевой, чужой географии и чужого интента.
- Отсеянное не удаляют, а откладывают в отдельный список — он станет минус-словами для контекста.
- Критерий готовности: по любой случайной выборке из 50 строк вы можете сказать, на какую страницу пойдёт каждая.
Четыре вида мусора
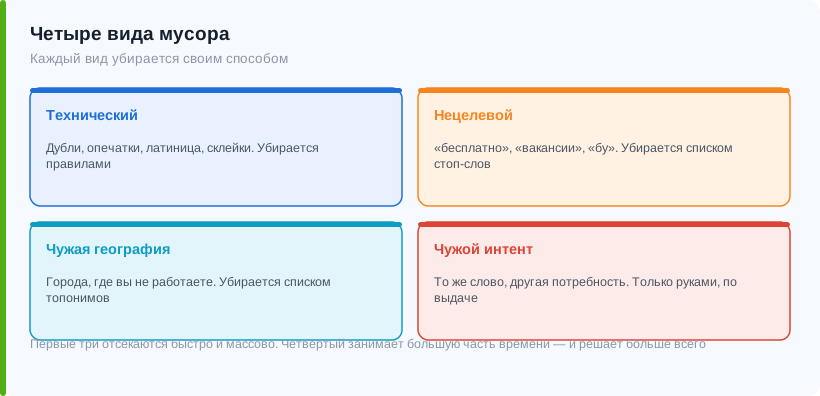
Прежде чем чистить, полезно понимать, что именно вы выбрасываете. Мусор в ядре бывает четырёх типов, и отсеиваются они разными способами.
| Тип | Примеры | Как отсекать |
|---|---|---|
| Технический | Дубли, опечатки, латиница в русской фразе, склейки слов | Автоматически, по правилам |
| Нецелевой | «бесплатно», «своими руками», «вакансии», «бу», «скачать» | Списком стоп-слов |
| Чужая география | Города, где вы не работаете | Списком топонимов |
| Чужой интент | Запросы про то же слово, но другую потребность | Вручную, по выдаче |
Первые три отсекаются быстро и массово. Четвёртый требует головы и занимает большую часть времени — но и решает больше всего.
Порядок чистки
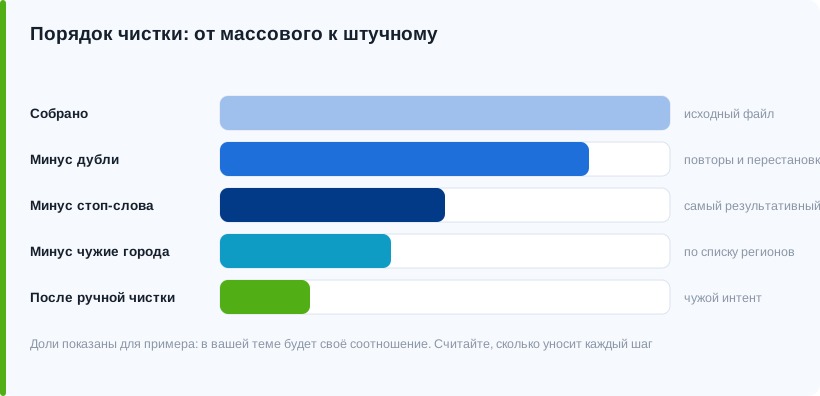
Работает принцип «от крупного к мелкому»: каждый следующий шаг применяется к тому, что осталось после предыдущего. Так вы не тратите внимание на строки, которые всё равно улетят.
Убрать явные дубли
Полные повторы и перестановки слов. Большинство инструментов сбора делает это само, но проверить стоит: дубли часто приходят из разных источников в разном написании.
Отсечь по стоп-словам
Прогоняете ядро по заранее собранному списку нецелевых слов. Это самый результативный шаг: обычно уносит от трети до половины строк.
Убрать чужие города
Список регионов России плюс страны СНГ. Оставляете только те, где реально работаете. Для локального бизнеса — отдельная осторожность: запрос со своим городом нужен, с соседним — нет.
Отфильтровать по частотности
Снимите точную частотность и отбросьте строки с нулём, если они при этом выглядят неестественно. Осмысленные нулёвки оставьте: в сумме они дают трафик.
Пройти остаток руками
Самый долгий шаг. Здесь отсеиваются запросы с чужим интентом, которые ни одно автоматическое правило не поймает.
Считайте, сколько ушло на каждом шаге. Если стоп-слова унесли 5% — список слабый, его нужно дополнять. Если 80% — вы, скорее всего, отрезали лишнее, стоит проверить выборочно.
Базовый список стоп-слов
Этот набор подходит почти любому коммерческому проекту. Свои отраслевые добавляются по ходу.
| Группа | Слова | Почему убираем |
|---|---|---|
| Бесплатное | бесплатно, даром, халява, бесплатный | Человек не собирается платить |
| Самодеятельность | своими руками, самому, самостоятельно, чертежи, инструкция по сборке | Ищут, как обойтись без вас |
| Работа | вакансии, работа, зарплата, обучение, курсы, резюме | Другая аудитория целиком |
| Вторичка | бу, б/у, подержанный, авито, юла | Не ваш товар и не ваш канал |
| Файлы | скачать, торрент, pdf, бланк, шаблон | Информационный интент |
| Порно и запрещённое | стандартный список | Приходит из парсеров, портит статистику |
Список не универсален. «Скачать» — мусор для мебельного магазина и целевой запрос для сервиса с программой. «Курсы» — мусор для автосервиса и главный запрос для учебного центра. Прежде чем применять чужой список, пройдите его глазами применительно к своей теме.
Самое сложное: чужой интент
Автоматика не отличит «ключ» гаечный от «ключа» лицензионного, «мыши» компьютерной от «мыши» живой, «ягуара»-автомобиля от «ягуара»-животного. Эти запросы формально релевантны вашим словам, но приводят не тех людей.
Как проверять
Единственный надёжный способ — посмотреть выдачу. Введите запрос в поиск и оцените топ-10:
Запрос ваш
- В топе — сайты, похожие на ваш
- Есть коммерческие страницы с ценами
- Выдача отвечает на ту же потребность, что закрывает ваш продукт
Запрос чужой
- В топе — Википедия, форумы, видео
- Выдача про другой предмет с тем же названием
- Сплошь агрегаторы и маркетплейсы, коммерческих сайтов нет
Проверять каждую строку невозможно, да и не нужно. Выборочно смотрят многозначные слова и те группы, где вы не уверены. Для остального хватает здравого смысла.
Что не выбрасывать, хотя хочется
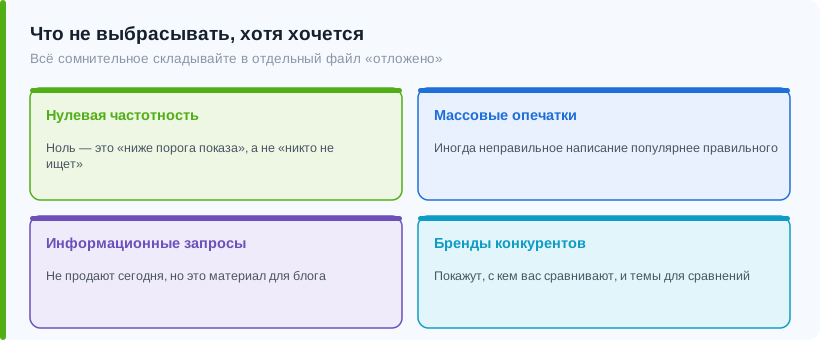
- Запросы с нулевой частотностью. Ноль в Вордстате означает «меньше порога отображения», а не «никто не ищет». Осмысленные длинные формулировки в сумме дают ощутимый трафик и почти не имеют конкуренции.
- Запросы с опечатками, если опечатка массовая. Поиск их исправляет сам, отдельная страница не нужна, но знать о них полезно — иногда «неправильное» написание популярнее правильного.
- Информационные запросы вашей темы. Они не продают напрямую, но это материал для блога и способ собрать аудиторию до момента покупки. Их не выбрасывают, а откладывают в отдельный список.
- Брендовые запросы конкурентов. Для SEO они почти бесполезны, но покажут, с кем вас сравнивают, и подскажут темы для сравнительных страниц.
Заведите файл «отложено». Всё, что отсеяли, но не считаете откровенным мусором, складывайте туда. Через полгода, когда появится блог или расширится ассортимент, этот файл сэкономит вам новый сбор.
Как понять, что ядро вычищено
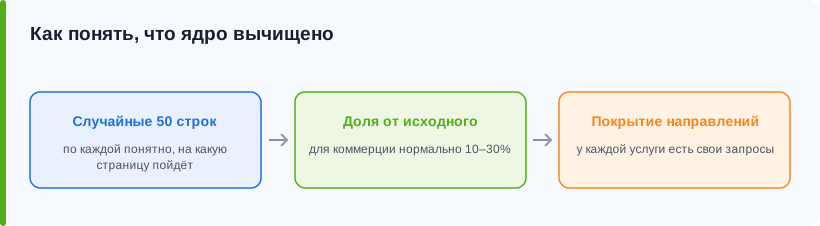
Формального критерия нет, но есть три рабочие проверки.
Тест случайной выборки
Возьмите 50 случайных строк. Если по каждой вы можете сказать, на какую страницу она пойдёт, — ядро готово. Если хотя бы по десяти возникает вопрос «а это вообще про что» — чистка не закончена.
Тест соотношения
Посчитайте, сколько строк осталось от исходного объёма. Для коммерческого проекта нормально 10–30%. Если осталось больше половины — вы, скорее всего, чистили поверхностно.
Тест покрытия
Пройдите по своим услугам или категориям товаров и проверьте, что у каждой есть запросы в ядре. Пустые направления означают, что при сборе что-то упустили.
После чистки ядро уходит на кластеризацию — именно там из списка запросов получается структура сайта.
Частые вопросы
Сколько времени занимает чистка ядра?
Зависит от объёма и от того, насколько хорош список стоп-слов. Для ядра на 5–10 тысяч строк с готовым списком — обычно рабочий день. Первый проект в новой тематике идёт дольше: половина времени уходит на то, чтобы собрать отраслевые стоп-слова.
Можно ли доверить чистку автоматике полностью?
Нет. Массовые отсевы автоматизируются хорошо, но чужой интент машина не различает: для неё «ключ от квартиры» и «ключ активации» одинаково релевантны слову «ключ». Ручной проход по остатку сокращать не стоит — именно он определяет качество структуры.
Нужно ли чистить ядро, если сайт уже работает?
Да, и это часто даёт быстрый результат. Ревизия показывает страницы, оптимизированные под нецелевые запросы, и запросы, под которые страниц нет вообще. Второе — самый дешёвый источник роста: контент уже есть, нужно только его дооптимизировать.
Куда девать отсеянные слова?
В отдельный файл. Нецелевые слова почти без изменений становятся минус-словами для контекстной рекламы — это экономит день работы при запуске кампаний. Информационные запросы уходят в контент-план блога.
Читайте также
Продвинем сайт в поиске
Соберём семантику, доведём структуру и текст до уровня топа и будем вести проект до заявок.
Обсудить SEO-продвижение